
こんにちは~ 浮田です。
■ TL;DR
-
2026年11月2日、Amazon Textract のテキスト検出モデルが更新され、日本語を含む40以上の言語に対応しました。APIの変更はなく、既存の呼び出しがそのまま新モデルで動きます
-
同じ日に、東京リージョン(ap-northeast-1)でも Textract が使えるようになりました。ただし AnalyzeExpense(請求書・領収書の項目抽出)などは東京ではまだ使えません
-
東京リージョンで69枚を検証。印刷された請求書は文字誤り率0.3%、重要項目8/8、表のセルは16/16。90°・180°の回転、15°の傾き、JPEG品質10でも崩れませんでした
-
ドキュメントでは「英語を含む欧州6言語のみ」のはずの FORMS(キーと値の抽出)が、日本語の申込書でも動きました(2026年11月3日時点)。チェックボックスの状態も正しく取れ、手書き風の申込書でもキーと値の対応付けは約85%でした
-
一方で、縦書きは全滅、「髙」は「高」に、「﨑」は「崎」に寄せられ、半角カナ・㌔・☎ などの特殊文字は取りこぼしあり。「×」は「X」として返ってきます
-
手書きは崩れるほど一気に弱くなります。筆順データから1画ずつ崩して書いた手書き風の画像では、雑に書いた版の文字誤り率が最大19.6%(同じ崩し方の英語は最大10.0%)。行が丸ごと消えても平均信頼度は90前後のままなので、信頼度だけでは気づけません
-
結論:「日本語に対応した」は本当。ただ「自分の帳票がそのまま読める」かどうかは、縦書き・人名の異体字・手書きの3点を必ず自分のデータで確認すべき、です
■ 目次
- はじめに
- 何が発表されたのか(ざっくり整理)
- 発表文とドキュメントが食い違っている
- 試した環境とテストデータ
- 実際に叩いてみた: 印刷された請求書
- 本日のオチ: 何が読めて、何が読めなかったか
- 詰まったところ
- こんな場面なら使えそう
- 感想
- 参考リンク
■ はじめに
2026年11月2日、Amazon Textract のテキスト検出モデルがアップデートされ、対応言語が40以上に増えました。同じ日に、東京リージョンでの提供開始も発表されています。公式発表
正直なところ、私の中では「Textract は英語の帳票用。日本語なら別の手段」くらいの認識でした。これまでは日本語が対応言語に入っておらず、無理もない話です。
そこにこのアップデートで、対応言語の一覧に「日本語」の文字。「え、本当に?」と半信半疑で、さっそく試してみました。
結論から言うと、印刷された日本語の帳票は、拍子抜けするくらい普通に読めました。でも、縦書きや人名の異体字など、日本語ならではのところでしっかりつまずきます。
その「読めるところ」と「つまずくところ」の境目を、69枚のテスト画像で切り分けた記録です。
対象読者は、「日本語帳票のOCRを検討しているけど、Textract は対象外だと思っていた」くらいの人です。
■ 何が発表されたのか(ざっくり整理)
|
変更点 |
発表での表現 |
|
対応言語の拡大 |
40以上の言語に対応。日本語、中国語(簡体字・繁体字)、韓国語、アラビア語、ヒンディー語などを含む |
|
精度の向上 |
長い単語の認識、手書きの検出が向上 |
|
表抽出の強化 |
結合セル、傾いた・回転した表、一部が欠けた表にも強くなった |
|
対象API |
DetectDocumentText と AnalyzeDocument |
|
使い方 |
リクエスト・レスポンスの形式は変更なし。自動で新モデルに切り替わる |
|
リージョン |
Textract が使える全リージョン |
|
東京リージョン(別の発表) |
同じ11月2日に提供開始。使えるのは DetectDocumentText / AnalyzeDocument と、その非同期版(Start/Get〜)。AnalyzeExpense・AnalyzeID・AnalyzeLending・カスタムクエリ(アダプター)は東京では未提供 |
請求書の処理と聞くと AnalyzeExpense を思い浮かべる方も多いと思いますが、東京リージョンではまだ使えません。今回の検証も、東京で使える DetectDocumentText と AnalyzeDocument で行っています。
もう一つのポイントは「自動で切り替わる」です。設定もオプトインも不要で、今動いているアプリケーションがそのまま新モデルで処理されます。ラクな反面、これが検証では少し困ったことになります(後述)。
■ 発表文とドキュメントが食い違っている
まず開発者ガイドの「Set Quotas in Amazon Textract」を読みました。すると、発表文と微妙に食い違う記述がいくつか出てきます。
|
項目 |
ドキュメントの記載(2026年11月3日時点) |
気になる点 |
|
全言語に対応するAPI |
AnalyzeDocument / StartDocumentAnalysis の TABLES / SIGNATURES / LAYOUT、非同期の StartDocumentTextDetection / GetDocumentTextDetection |
発表文にある同期の DetectDocumentText が一覧に載っていない。文字どおり読むと「その他のAPIは英語のみ」に入ってしまう |
|
FORMS |
英・西・伊・葡・仏・独の6言語のみ |
日本語の申込書は対象外? |
|
Queries ほか |
「その他のAPIは英語のみ」 |
日本語のQueriesは対象外 |
|
手書き |
「手書き認識は英語のみ」 |
発表文の「手書き検出の向上」は日本語に効く? |
|
文字の向き |
「横書きのテキストに対応」 |
縦書きは対象外 |
|
最小の文字の高さ |
15px(150dpiで約8pt) |
|
|
検出できる文字 |
ラテン文字だけが列挙されている |
おそらく更新が追いついていない |
発表直後なのでドキュメント側の更新が追いついていない可能性もあります。推測しても仕方ないので、実際に叩いて確かめることにしました。
先に答えを書いておくと、同期の DetectDocumentText でも、日本語はエラーなく普通に処理されました。以降の結果は、すべて同期APIで取ったものです。
もう一つの落とし穴が、旧モデルと比べられないことです。自動で切り替わるので、Before を取る手段がありません(そもそも東京リージョンは今回が初提供です)。レスポンスの DetectDocumentTextModelVersion も "1.0" が返ってくるだけで、新旧の区別には使えませんでした。そこで今回は、比較の軸を次の2つにしています。
- 正解テキストとの比較(自作の画像なので正解が手元にある)
- 英語・韓国語・中国語との相対比較(同じ内容の画像を同条件で投げる)
■ 試した環境とテストデータ
- リージョン: 東京(ap-northeast-1)
- API: 同期の DetectDocumentText、AnalyzeDocument(TABLES + LAYOUT)、一部で AnalyzeDocument(FORMS)
- SDK: boto3(Python)。生のレスポンスJSONを全部保存して、後から集計しました。発表直後の検証は、あとで別の切り口で見直したくなることが多いので、これが一番確実です
- 再現性の確認のため、3枚は同じ画像を3回ずつ投げています
テストデータはすべて Python(Pillow)で自作した帳票です。手書き風の一部には、漢字・かなの筆順データ KanjiVG(CC BY-SA 3.0)を使っています。
|
カテゴリ |
内容 |
枚数 |
|
請求書 |
T番号・金額・振込先入りの請求書(ゴシック/明朝) |
2 |
|
文字種 |
㈱、丸数字、髙・﨑などの異体字、全角/半角英数、半角カナ、長音とマイナス、㍻・㌔など |
1 |
|
縦書き |
縦書きの文章 |
1 |
|
表 |
結合セルあり、罫線なし |
2 |
|
申込書 |
キーと値の欄、チェックボックス |
1 |
|
文字サイズ |
フォントサイズ 10 / 12 / 15 / 18 / 24px |
1 |
|
劣化 |
回転(90/180/270°)、傾き(5/10/15°)、低解像度(100/75dpi相当)、JPEG品質10、ノイズ+ぼかし |
10 |
|
手書き風(フォント) |
手書き風フォント8種類 × きれい/崩し(文字ごとの傾き・大きさ・位置のゆらぎ、青インク、罫線ノート)+スマホ撮影風2枚、旧サンプル2枚 |
20 |
|
手書き風(筆順データ) |
筆順データから1画ずつゆらして描画。書き手4人 × 丁寧/普通/雑 |
12 |
|
対照 |
英語・韓国語・中国語の請求書(表のない簡易版)、英語の手書き風フォント4枚、英語の筆順データ手書き風12枚(日本語と同じ書き手・同じ崩し方) |
19 |
|
合計 |
|
69 |
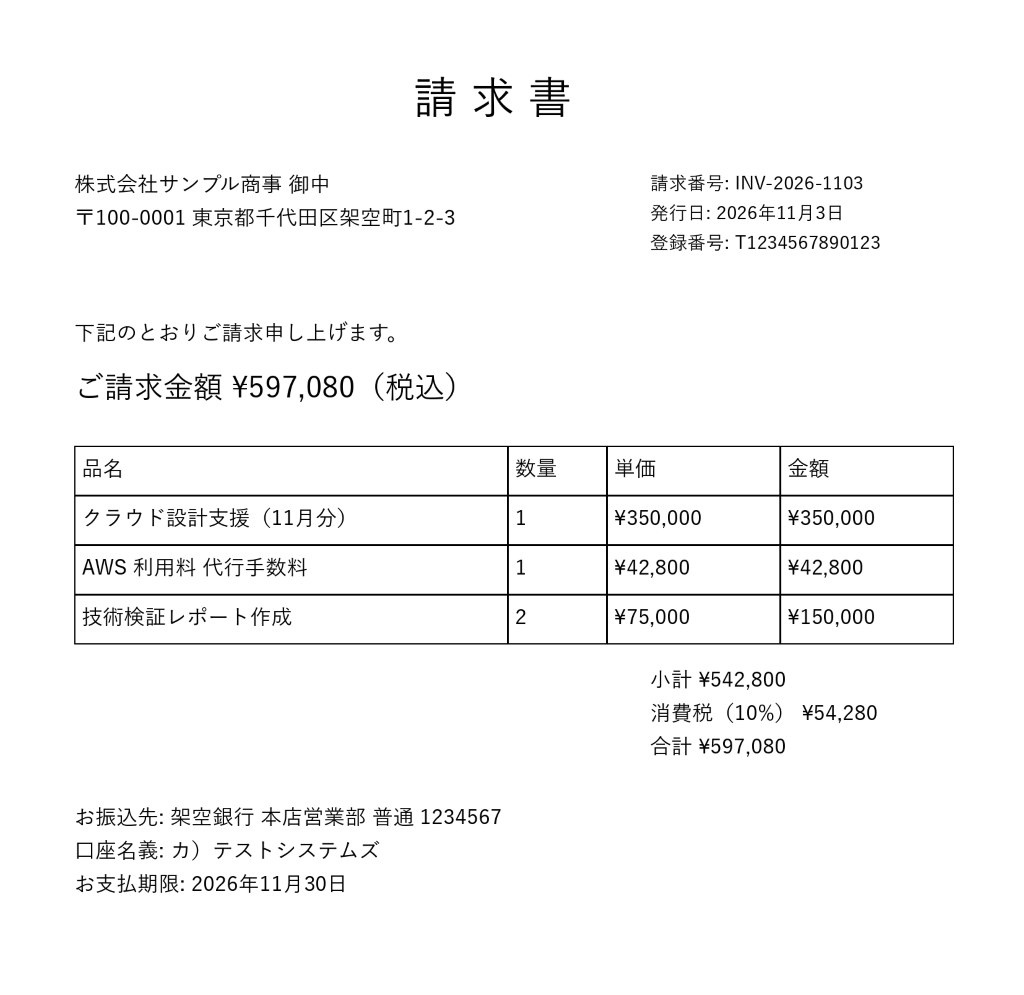
▲ 請求書のテスト画像(架空データ)
▲ 手書き風フォント
評価の指標はこちらです。
|
指標 |
出し方 |
|
文字誤り率(CER) |
正解との編集距離 ÷ 正解の文字数。空白は除外。全角/半角の違いを吸収した値(NFKC正規化後)も出す |
|
重要項目 |
金額・日付・T番号・氏名など、業務で外せない項目が完全一致で取れたか |
|
表セル一致 |
行・列の位置と中身が正解と一致したセルの数 |
|
信頼度 |
WORD ごとの Confidence |
■ 実際に叩いてみた: 印刷された請求書
まずは一番の本命、印刷された請求書です。
請求書
株式会社サンプル商事 御中
請求番号: INV-2026-1103
〒100-0001 東京都千代田区架空町1-2-3
発行日: 2026年11月3日
登録番号: T1234567890123
下記のとおりご請求申し上げます。
ご請求金額 ¥597,080 (税込)
...
小計 ¥542,800
消費税 (10%) ¥54,280
合計 ¥597,080
お振込先: 架空銀行 本店営業部 普通 1234567
口座名義: 力) テストシステムズ
お支払期限: 2026年11月30日
▲ DetectDocumentText の LINE を並べたもの(抜粋)
ほぼ完璧です。
T番号、金額、日付、振込先の口座番号まで、重要項目は8/8で取れました。
文字誤り率は0.3%(全角/半角の違いを吸収した値)。間違えたのは1文字だけで、口座名義の「カ)」(カタカナ)が「力)」(漢字のちから)になっていました。
これ、人間でも見間違える可能性はありますが、経理の人なら「口座名義の先頭だからカタカナのカ」と文脈で自然に読み分けるところです。Textract は字形だけで読むので、ここは取り違えました。
AI-OCRではこういうのは読み取れるのでしょうか?気になりますね。
そしてここが面白いところで、この単語の信頼度だけが75.4と低く、他の50語はすべて95以上(うち46語は99以上)でした。「信頼度が低い単語だけ人が確認する」という運用がちゃんと成り立ちそうです。
AnalyzeDocument(TABLES)で明細の表も見てみました。4行×4列の16セルがすべて正しい位置に、正しい中身で返ってきています。LAYOUT もタイトル・本文・表をきちんと分けてくれました。
さらに、この請求書を回転・劣化させた10パターンの結果がこちらです。
|
条件 |
文字誤り率(NFKC) |
重要項目 |
表セル |
|
元画像 |
0.3% |
8/8 |
16/16 |
|
90° / 180° / 270° 回転 |
0.3% |
8/8 |
16/16 |
|
5° / 10° / 15° 傾き |
0.0〜0.3% |
8/8 |
16/16 |
|
100dpi相当 |
0.3% |
8/8 |
16/16 |
|
75dpi相当 |
0.3% |
7/8 |
16/16 |
|
JPEG品質10 |
0.3% |
8/8 |
16/16 |
|
ノイズ+ぼかし |
0.3% |
8/8 |
16/16 |
回転や傾きでは精度に変化は確認できませんでした。
唯一崩れたのが75dpi相当で、「サンプル」が「サンブル」(プ→ブ)になりました。半濁点の丸が潰れるのは、解像度を下げたら当然の結果です。スキャンは150dpi以上にしておくのが無難そうです。
同じ画像を3回投げた結果も、3回とも一字一句同じでした。結果が毎回ぶれる心配はなさそうです。
■ 本日のオチ: 何が読めて、何が読めなかったか
さて本題、というか本日のオチです。全カテゴリの結果をまとめるとこうなりました。
|
条件 |
結果 |
文字誤り率(NFKC) |
ひとこと |
|
印刷の請求書(ゴシック・明朝) |
✅ |
0.3% |
書体による差はなし |
|
回転・傾き・JPEG劣化・ノイズ |
✅ |
0.0〜0.3% |
精度に変化なし |
|
結合セルの表 |
✅ |
0.0% |
22/22セル。結合セルも2つとも検出 |
|
罫線なしの表 |
✅ |
0.0% |
16/16セル |
|
申込書(FORMS) |
✅ |
0.0% |
ドキュメント上は非対応なのに取れた(後述) |
|
フォントサイズ 15px以上 |
✅ |
– |
ドキュメントの「最小15px」とほぼ一致(ドキュメントは文字の高さなので厳密には別物) |
|
フォントサイズ 10〜12px |
⚠️ |
– |
10pxでT番号の「T」が消え、12pxで「書」が「青」に |
|
手書き風フォント(日本語18枚) |
⚠️ |
1.5〜6.4% |
重要項目は14項目中8〜11 |
|
筆順データの手書き風・丁寧(日本語4枚) |
⚠️ |
2.0〜5.4% |
フォントとほぼ同じ水準 |
|
筆順データの手書き風・雑に(日本語4枚) |
❌ |
5.4〜19.6% |
行が丸ごと消えることも。同条件の英語は0.8〜10.0% |
|
特殊文字・異体字 |
⚠️ |
7.9% |
髙→高、﨑→崎、半角カナ・㌔が崩れる |
|
縦書き |
❌ |
100%超 |
読み順も文字もバラバラ |
|
対照: 英語・韓国語・中国語 |
✅ |
0.0% |
誤りなし。ただし表のない簡易版なので、日本語の請求書と同条件の比較ではない |
■ 縦書きは全滅
縦書きの「吾輩は猫である。名前はまだ無い。……」は、こうなりました。
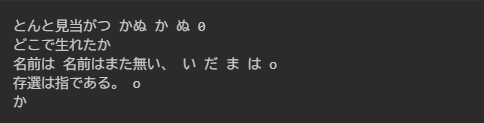
▲ 縦書きの認識結果。
「吾輩は猫である」が「存選は指である」に
右の列から読むべきところが左の列から並んでいて読み順は逆、文字自体も崩れています。
ドキュメントに「横書きに対応」とあるとおりで、縦書きは対象外と考えたほうがよいです。
● 「髙橋さん」が「高橋さん」になる
文字種のテストで一番気になったのがこれです。
|
書いた文字 |
返ってきた文字 |
判定 |
|
㈱テスト |
(株)テスト |
✅ 意味は同じ |
|
①②③ |
1 2 3 |
⚠️ 丸が消える |
|
髙橋(はしご高) |
高橋 |
❌ 標準の字体に寄せられる |
|
﨑山 |
崎山 |
❌ 同上 |
|
𠮷野(※つちよし(「士(さむらい)」ではなく「土(つち)」 )) |
吉野 |
❌ 同上 |
|
辻󠄀(一点しんにょう、異体字セレクタ付き) |
辻 |
⚠️ 字形の指定が消える |
|
齋藤・渡邉・邊見 |
そのまま |
✅ |
|
ABC123(※全角) |
ABC 1 23 |
⚠️ 半角になる |
|
カタカナ(※半角) |
カカナ |
❌ |
|
㍻ |
平成 |
✅ 展開してくれる |
|
㌔ ㌢ |
き センチチ |
❌ |
|
☎ ※ |
(消える) |
❌ |
|
℡ |
TEL |
✅ 展開してくれる |
|
ゐ |
る |
❌ |
「齋藤」「渡邉」は読めるのに、「髙」「﨑」「𠮷」は標準の字体に寄せられています。
手書き風フォントの日本語18枚でも、「髙橋」は1枚の例外もなくすべて「高橋」になりました。
請求書の宛名くらいなら困りませんが、人名をキーにした突き合わせ(顧客マスタとの照合など)には要注意です。
● 手書き風フォント: 意外と読める。でも「手書き」としては読まれていない
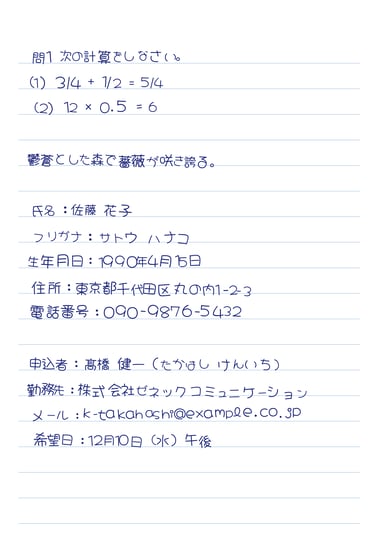
手書き風フォント8種類を、きれいに書いた版と、文字ごとに傾き・大きさ・位置をゆらした「崩し」版で試しました。
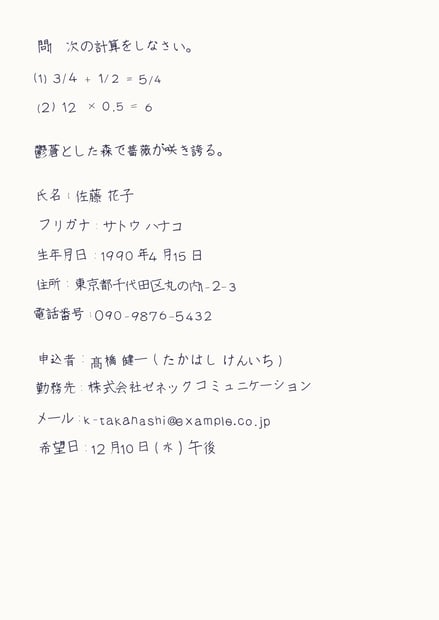
問1 次の計算をしなさい。
(1) 314 + 1/2 5/4
(2) 12x 0.5 6
響替とした森で薇が咲き誇る。
氏名: 佐藤 花子
...
希望日: 12月10日 (א) 午後
▲ 崩し版で一番崩れた例(はちまるポップ体)。「鬱蒼」が「響替」、「3/4」が「314」に。「(水)」の「水」はヘブライ文字の「א」になりました。対応言語が増えたぶん、似た形の他言語の文字に化けることもあるようです
|
フォント |
きれい版 |
崩し版 |
|
UDデジタル教科書体 |
2.5% |
1.5% |
|
HG正楷書体 |
1.5% |
2.0% |
|
HG行書体 |
6.4% |
3.9% |
|
Yomogi |
1.5% |
2.0% |
|
Zen Kurenaido |
2.0% |
2.0% |
|
Klee One |
2.0% |
2.0% |
|
はちまるポップ体 |
2.5% |
4.4% |
|
Yusei Magic |
1.5% |
2.9% |
|
スマホ撮影風(Yomogi / Klee One) |
2.5% / 1.5% |
– |
|
対照: 英語の手書き風(Segoe Print / Ink Free) |
0.4% / 1.3% |
0.4% / 2.9% |
▲ 文字誤り率(NFKC)
崩し版のほうが悪くなるとは限らず、HG行書体はむしろきれい版のほうが誤りが多くなりました(住所の「区」が「已」、メールアドレスの「.」が「,」や「、」に)。1枚ごとのばらつきが大きいので、フォント同士の細かい順位にはあまり意味がないと考えてください。
氏名・電話番号・住所・メールアドレスなど、帳票によくある項目はほとんどのフォントで取れました。逆に、18枚すべてで1回も正しく読めなかったのが次の3つです。
- 「薔薇」: 「薇」だけになったり、「普薇」「審薇」「善」になったり。18枚中0枚
- 「髙」: 前述のとおり、必ず「高」。18枚中0枚
- 「×」: 必ず「X」か「x」。18枚中0枚。計算式をそのまま扱いたいなら後処理が必要
……と、ここまでは「項目はおおむね取れている」という話なのですが、但し書きを1つ。
Textract は WORD ごとに TextType(PRINTED か HANDWRITING)を返します。
これを集計したところ、
|
サンプル |
判定 |
|
英語の手書き風フォント(4枚) |
ほぼすべて HANDWRITING |
|
日本語の手書き風フォント(18枚) |
すべて PRINTED |
日本語の手書き風フォントは、「手書き」ではなく「ちょっと崩れた活字」として読まれていました。ドキュメントの「手書き認識は英語のみ」とも辻褄が合います。手書き風フォントは同じ字が毎回同じ形で、線もきれいです。Textract から見れば活字と変わらないのでしょう。
(例外として、最初に作った簡易版の手書き風サンプル2枚では、日本語の3語が HANDWRITING と判定されました。行書体の2語は「千代田区」が「千代田已」、「問い合わせ」が「向い合わせ」と誤認識、楷書体の「合計」は信頼度99.9で正しく読めていて、傾向と呼べるほどの差はありませんでした。)
これでは手書きを試したことにならないので、もう一歩踏み込んでみました。
● 筆順データで1画ずつ崩すと、精度が一気に落ちる
フォントの代わりに、漢字・かなの筆順データ(KanjiVG)を使い、1画ずつ線を引いて手書き風の画像を作りました。画ごとに位置・角度・長さをずらし、線には手のふるえを足しています。払いやハネでは筆圧を抜き、雑に書いた版では画と画を細い線でつなぐ「続け字」も入れました。同じ字でも、書くたびに形が変わります。
クセの違う書き手(パラメータで作った架空の書き手)を4人用意し、それぞれ「丁寧」「普通」「雑」の3段階で、同じ文面を書かせています。比較のため、同じ書き手・同じ崩し方で英語版も作りました。
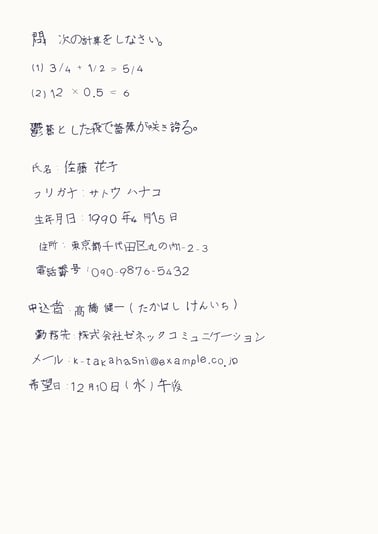
▲ 筆順データから描いた手書き風(書き手4・雑)。「髙」と「@」は筆順データにないので、手書き風フォントで代用しています
|
|
丁寧 |
普通 |
雑 |
|
日本語(4人) |
2.0〜5.4% |
2.5〜9.3% |
5.4〜19.6% |
|
英語(同じ4人) |
0.4〜0.8% |
0.4〜2.9% |
0.8〜10.0% |
▲ 文字誤り率(NFKC)
丁寧に書けば手書き風フォントとほぼ同じ水準ですが、崩れるほど一気に悪くなり、同じ崩し方の英語と比べて2〜5倍の誤り率になりました。
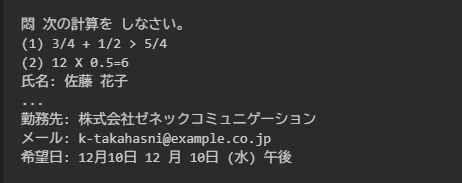
▲ 上の画像の認識結果(抜粋)。「問1」が「悶」に、「=」が「>」に。そして「鬱蒼とした森で薔薇が咲き誇る。」の行が丸ごと消えています(「(2)」の行の次が、いきなり「氏名」)。
最後の行では、逆に「12月10日」が二重に出ています
ここで一番怖かったのが、行や項目が丸ごと消えることです。日本語12枚のうち4枚で、「鬱蒼とした森で薔薇が咲き誇る。」の行や、メールアドレスがまるごと出力から消えました。エラーも空欄の印も出ません。しかも、
|
サンプル |
文字誤り率 |
平均信頼度 |
信頼度80未満の語 |
|
書き手2・雑 |
16.7% |
90.8 |
11% |
|
書き手4・普通(1行まるごと消失) |
9.3% |
94.3 |
3% |
と、平均信頼度はほとんど下がりません。
消えた行には、そもそも信頼度が付かないからです。「信頼度の低い項目だけ人が確認する」運用では、この取りこぼしに気づけません。必須項目が空になっていないか、合計が合うか、といったチェックを別に入れる必要がありそうです。
TextType も見てみました。
|
|
丁寧 |
普通 |
雑 |
|
日本語: HANDWRITING と判定された語 |
0語(4人とも) |
0〜4語 |
0〜12語(全体の0〜29%) |
|
英語: HANDWRITING と判定された語 |
0〜1語 |
0〜13語 |
1〜40語(最大で全体の83%) |
英語は崩れるほど「手書き」と判定されるのに対し、日本語は雑に書いてもほとんどが「活字」扱いのままでした。日本語の帳票では、TextType で手書き部分を見分けて振り分けることは難しいと考えたほうがよさそうです。
なお「薔薇」は12枚すべてで読めず、「×」も11枚で「X」になりました。手書き風フォントと同じ結果です。
ただし、これもあくまで「本物っぽく崩した手書き風」です。筆順データの字形は教科書的な形なので、人それぞれのクセや、かすれ・筆圧の違いまでは再現できていません。本物の手書きの実力は、実際にペンで書いた紙で確かめる必要があります。
■ 詰まったところ
ここからは、実際に作業していて引っかかったところです。
● ① 文字誤り率が「全部2.6%」で揃って見えた → 全角カッコが半角になっていた
最初の集計では、請求書のどのパターンも文字誤り率が2.6%で横並びでした。「回転させても劣化させても、なぜ同じ数字?」と思って中身を見ると、
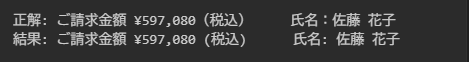
全角の「()」「:」が、半角の「()」「:」で返ってきていました。 誤りの大半はこれで、全角/半角の違いを吸収する正規化(NFKC)をかけると0.3%まで下がります。
後段で文字列を完全一致で突き合わせる処理があるなら、Textract の出力側も比較対象側も、正規化してから比べるのが安全です。
● ② 日本語の WORD は「単語」ではなく「ほぼ1行」
信頼度を単語単位で見ようとしたところ、日本語の WORD がこうなっていました。
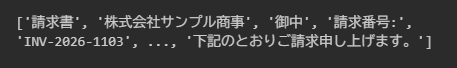
日本語は単語の間に空白がないので、WORD の区切りは「空白で区切られたかたまり」になります。
文章だと1行まるごと1 WORDです。「鬱蒼とした森で薇が咲き誇る。」の信頼度は57.7でしたが、どの文字が怪しいのかまでは分かりません。
信頼度で人の確認に回す運用をするなら、項目ごと(=空白や罫線で区切られた単位)に信頼度を見る設計にするのが現実的そうです。
● ③ FORMS は「非対応」のはずが、普通に動いた
ドキュメントでは FORMS は欧州6言語のみ。なので、日本語の申込書ではエラーか空の結果が返ってくると予想していました。ところが、
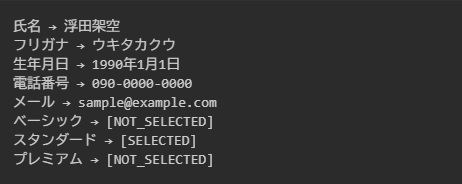
▲ AnalyzeDocument(FORMS)の KEY_VALUE_SET を整形したもの
キーと値のペアが8件すべて正しく取れて、チェックボックスの状態まで合っています。 請求書でも「登録番号: → T1234567890123」「合計 → ¥597,080」など13ペアが返ってきました。
ただし、うち3件(「代行手数料 →(空)」「単価 → ¥350,000」など)は明細の表の中身を誤ってペアにしたもので、口座名義も「力)」のままです。
手書きでも試してみました。筆順データで作った手書き風の申込書12枚(9項目ずつ、計108ペア)に FORMS をかけた結果です。
|
結果 |
件数 |
|
キーと値の対応付けも、値の中身も完全一致 |
78(72%) |
|
対応付けは正しいが、値に誤字がある |
12(11%) |
|
対応付けは正しいが、値が空(行ごと消えたもの) |
2(2%) |
|
対応付けに失敗 |
16(15%) |
▲ 「髙」→「高」は一致扱いで集計
「どれがどの項目の値か」の対応付けは85%で、日本語は対象外のはずにしては意外と優秀です。面白いのは崩し方との関係で、
|
|
完全一致 |
値に誤字・空 |
対応付けに失敗 |
|
丁寧 |
24 |
3 |
9 |
|
普通 |
29 |
3 |
4 |
|
雑 |
25 |
8 |
3 |
値の誤字は字が崩れるほど増えますが、対応付けの失敗は字のきれいさとほぼ関係なく、丁寧に書いた版でむしろ多いくらいでした。
失敗が集中していたのは「申込者:髙橋 健一(たかはし けんいち)」の項目です。12枚中7枚で、
申込者:高橋健一 → (たかはしけんいち)
と、名前がキーの側に入ってしまいました。
正しく「申込者 → 高橋健一(たかはしけんいち)」と取れたのは3枚だけです。手書き風フォントのきれいな版でも、「高橋健一」が値の空いた別のキーにされていました。
値に空白やカッコが入っていると、その手前でキーと値を区切ってしまうようです。一方、「住所」「電話番号」「勤務先」のように値がひとかたまりの項目は、12枚すべてで正しく対応付けられています。
実務で使うなら、帳票の項目名の一覧を自分で持っておき、「キーが項目名で始まっていたら、後ろを値に戻す」といった後処理を入れるのが現実的です。決まった様式の帳票なら、FORMS を使わずに DetectDocumentText の行を「:」で区切るほうが安定することもあります(料金も1ページ $0.05 → $0.0015 と大きく下がります)。
ただし、ドキュメント上は対応言語に入っていないので、今動いていても、サポート対象外の挙動という扱いになります。本番で頼るなら、ドキュメントが更新されるのを待つか、自分のデータで十分に検証してから、が安全です。
■ こんな場面なら使えそう
|
用途 |
判定 |
ポイント |
|
印刷された請求書・見積書の取り込み |
✅ そのまま使える |
回転・傾き・画質の劣化にも強い。信頼度の低い項目だけ人が確認 |
|
表(明細・一覧表)の抽出 |
✅ そのまま使える |
結合セル・罫線なしもOK |
|
申込書のキーと値の抽出(FORMS) |
⚠️ 要検証 |
動くが、ドキュメント上は対象外。手書きでも対応付けは約85%。値に空白やカッコがある項目は、キーと値の区切りを間違えやすい |
|
顧客名・人名での照合 |
⚠️ 要後処理 |
髙→高、﨑→崎。異体字を正規化してから照合 |
|
数式・記号を含む文書 |
⚠️ 要後処理 |
×→X、①→1、☎・※は消える |
|
手書きの帳票 |
⚠️ 要検証 |
丁寧な字なら読めるが、崩れると急に悪化し、項目が丸ごと消えることも。信頼度では気づけないので、必須項目と合計のチェックを入れる。実物で確認必須 |
|
請求書の項目を自動で分類(AnalyzeExpense) |
❌ 東京では未提供 |
東京で使うなら FORMS や自前の後処理で代用 |
|
縦書きの文書 |
❌ 向かない |
別の手段を検討 |
|
小さい文字(8pt未満) |
⚠️ 要対策 |
スキャン解像度を上げて、文字の高さを15px以上にする |
■ 料金の目安
|
使い方 |
1ページ |
1万ページ |
|
文字だけ(DetectDocumentText) |
$0.0015 |
約$15 |
|
表も取る(AnalyzeDocument TABLES。LAYOUTは同時なら無料) |
$0.015 |
約$150 |
|
キーと値も取る(FORMS) |
$0.05 |
約$500 |
今回の69枚の検証は、全部で約2ドルでした。自分の帳票で試すのも、気軽にできる金額です。
※2026年11月時点の東京リージョンの料金。最新は料金ページを確認してください。
■ 感想
正直、ここまで普通に読めるとは思っていませんでした。印刷された請求書なら、回転していても、JPEGでガビガビでも、表に結合セルがあっても、ほぼそのまま取れます。日本語の請求書処理を Textract に乗せる、というのは十分に現実的な選択肢になったと思います。
一方で、日本語特有のところ縦書き、人名の異体字、半角カナや組文字では、まだしっかりつまずきます。
ここは「英語ほか40言語のひとつとして対応した」ということなのだと思います。
一番の収穫は、「対応言語に載った」と「自分の帳票が読める」は別物で、その差は縦書き・異体字・手書きの3か所に集中している、と分かったことでした。逆に言えば、この3つが関係ない帳票なら、かなり期待してよさそうです。
■ 参考リンク
- Announcing an updated text detection model for Amazon Textract(What's New, 2026-11-02)
- Set Quotas in Amazon Textract(対応言語・制約)
- Amazon Textract の料金
- Amazon Textract FAQ
- KanjiVG(手書き風画像の作成に使用した筆順データ。CC BY-SA 3.0。筆順データから作った画像も同じライセンスです)
※この記事は2026年11月3日時点の東京リージョン(ap-northeast-1)での挙動に基づきます。テスト画像はすべて Python で生成した架空のデータで、実際のスキャン画像より条件が良い点にご注意ください。対応状況や精度、ドキュメントの記載は今後変わる可能性があります。