こんにちは~ 浮田です。
■ TL;DR
- ハーネスで作ったエージェントを「社内の非エンジニアに配る」ことを考えて、入口から権限・課金まで一式作ってみました
- プレイグラウンドは配れません。あれは AWS コンソールの中の画面です。配るには「入口・本人確認・権限・お財布・記録」の5点セットが要ります
- 一番の発見は、アクター ID は「名乗り」であって「認証」ではないこと。同じセッションで ID を書き換えたら、他人の記憶が読めてしまいました。名乗りを固定するのは入口の仕事です
- 検索のドメインを公式サイトに絞る実験では、プロンプトを一切変えずに出典が全部 aws.amazon.com になりました。エージェント本人は絞られたことに気づいていません
- 上限を絞って調査を頼んだら、英語の警告でぶつ切りになりました。18,000 トークン払って比較表はゼロ。止まり方の面倒を見るのも入口の仕事です
- 結論:配るとは、エージェントの周りに利用者側の身の回り一式をもう1周作ることでした
■ 目次
- はじめに
- 前提:ハーネスは「配れる側」の道具である
- ところが、プレイグラウンドは渡せない
- 「配る」を分解すると5つある
- 実験台:調べ物アシスタントを作る
- ① 入口:プレイグラウンドの代わりに何を置くか
- ② 本人確認:誰が使っているのか
- ③ 権限:エージェントに気づかれずに絞る
- ④ お財布:エージェントは黙ってループする
- ⑤ 記録:何を聞かれたか追えるか
- 詰まったところ
- まとめ・次にやりたいこと
- 参考リンク・但し書き
■ はじめに
第1弾でモデルを差し替えて遊んだあと、ずっと引っかかっていたことがあります。これ、誰に使ってもらうんだろう。
エージェントは作れました。会話も覚えるし、モデルも替えられる。でも私が触っていたのは AWS マネジメントコンソールの中のプレイグラウンドで、社内の営業さんや経理さんはそこには居ません。「作れる」と「使ってもらえる」の間には、思ったより距離がありました。
今回はその距離を全部歩いてみます。対象読者は「エージェントは作った。次は人に使わせたい」人です。
■ 前提:ハーネスは「配れる側」の道具である
先に良い話をします。
開発者向けのコーディングアシスタント(Claude Code や Kiro など)は、開発者自身がターミナルや IDE で使う道具です。優秀ですが、「自分のアプリのユーザーに使わせる」仕組みはそもそも持っていません。
一方ハーネスは、InvokeHarness という API で呼べます。つまり最初からサービスとして人に提供できる側の作りです。
|
観点 |
コーディングアシスタント |
AgentCore ハーネス |
|
誰が使う |
開発者本人 |
エンドユーザーにも渡せる |
|
呼び出し |
ローカル / IDE |
API(InvokeHarness) |
|
認証 |
個人の認証情報 |
呼び出し側で設計できる |
|
記憶の持ち主 |
自分だけ |
ユーザーごとに分けられる(後述のアクター ID) |
方向性としては合っているんです。
■ ところが、プレイグラウンドは渡せない
「お、これもう完成してるじゃん」と一瞬テンションが上がったんですが、よく考えたら渡せません。プレイグラウンドは AWS マネジメントコンソールの中の画面です。非エンジニアに渡すということは、AWS アカウントへのアクセスを渡すということ。
営業の A さんに IAM ユーザーを発行して、リージョンを us-east-1 に切り替えてもらって、AgentCore のコンソールを開いてもらって……無理です。ここまで書いていて、当たり前すぎて笑ってしまいました。
じゃあ何が必要なのか。「配る」を分解するところから始めます。
■ 「配る」を分解すると5つある
社内に新しく人を1人迎えるのと同じでした。そもそも編で「モデルが優秀な人、ハーネスが机と PC」という話をしましたが、配るときは迎える側の準備がもう1周要ります。
|
# |
要素 |
会社でいうと |
何が問題か |
|
① |
入口 |
席 |
どこから話しかけてもらうか |
|
② |
本人確認 |
社員証 |
誰が使っているか分かるか |
|
③ |
権限 |
鍵 |
触っていいものだけ触らせられるか |
|
④ |
お財布 |
経費の上限 |
暴走したときに誰が払うのか |
|
⑤ |
記録 |
日報 |
何を聞かれて何をしたか、後から追えるか |
この5点セットが揃って初めて人に任せられます。以降、1つずつ実際に作って・壊して確かめていきます。
■ 実験台:調べ物アシスタントを作る
実験台には「調べ物アシスタント」を作りました。「○○について調べて比較表にして」と頼むと、Web で調べて出典付きの表を返してくれるやつです。構成はこうです。
利用者 → 入口(自作の最小Webアプリ) → ハーネス
├ Gateway ── Web Search Tool(検索)
├ コードインタープリター(表の整形)
└ メモリ ON
検索には、AgentCore の Web Search Tool を使いました。
Gateway に組み込みコネクタ(MCP ターゲット)として追加すると、エージェントが自然文のクエリを投げるだけで、スニペット・URL・タイトル・公開日が構造化されて返ってきます。検索クエリは AWS の外に出ない設計で、Amazon 自身の検索インデックス+ナレッジグラフが裏側です。ブラウザツール(ヘッドレスブラウザ)もありますが、調べ物ならこちらのほうが速くて出典がきれいでした。
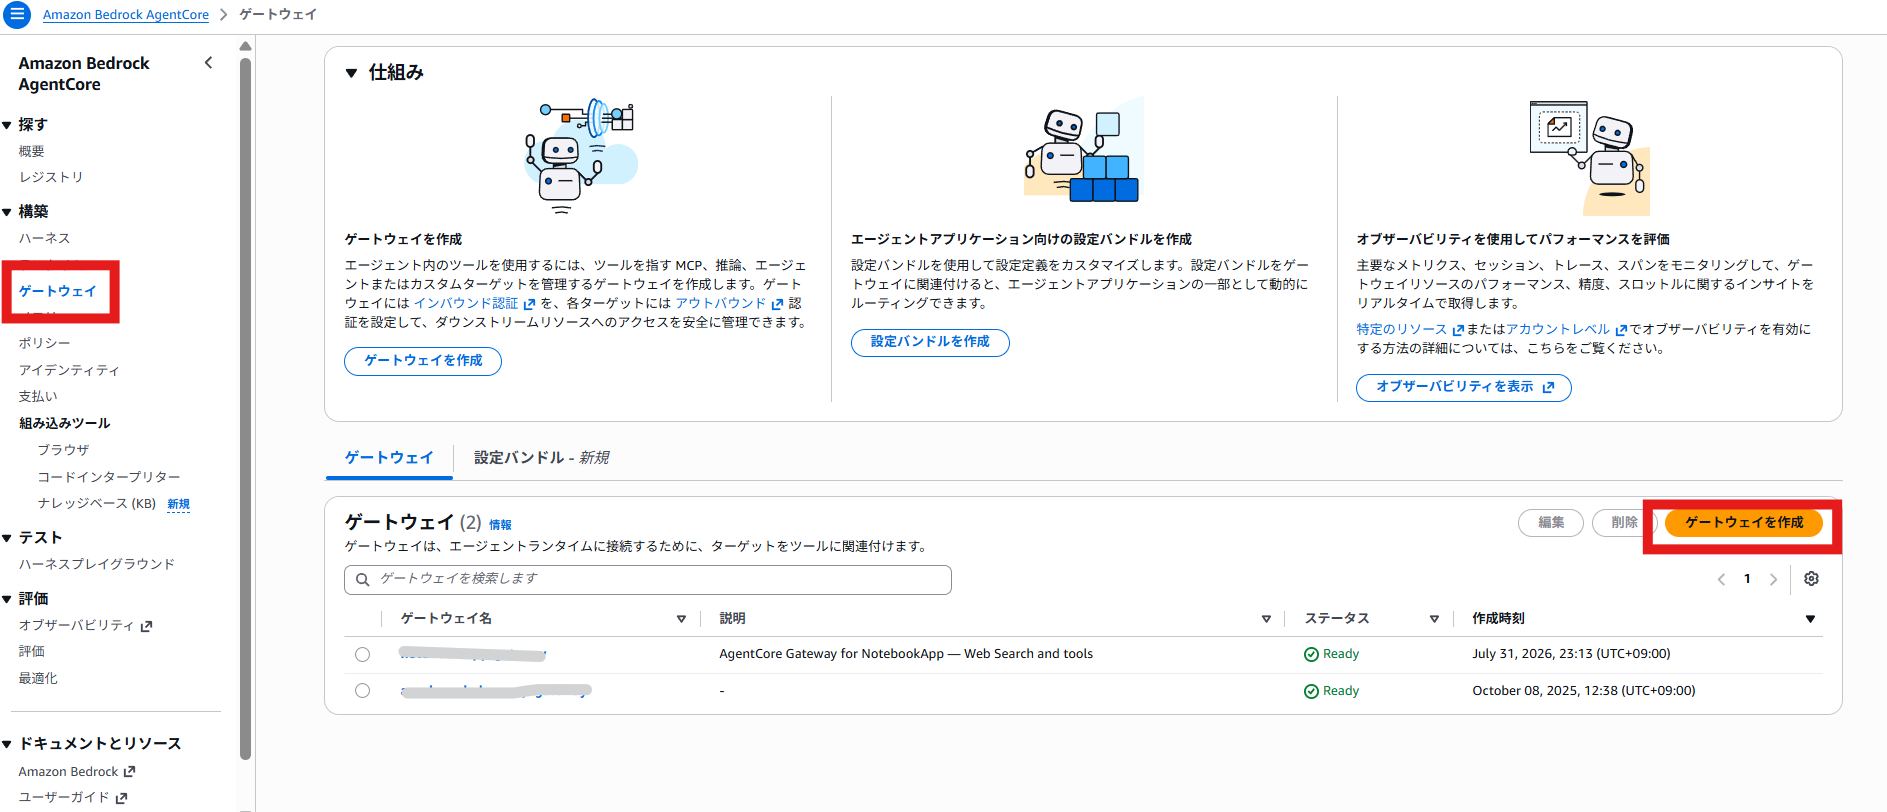
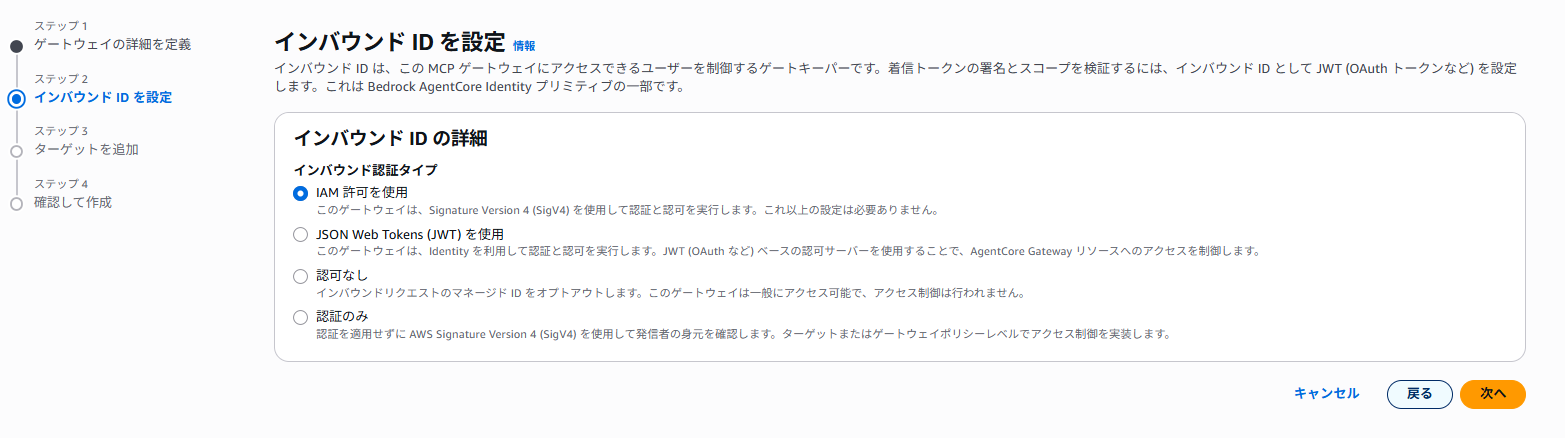
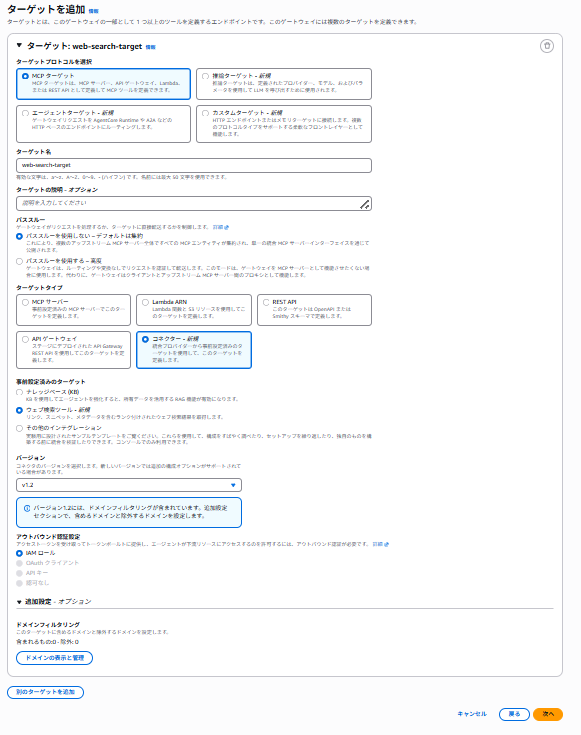
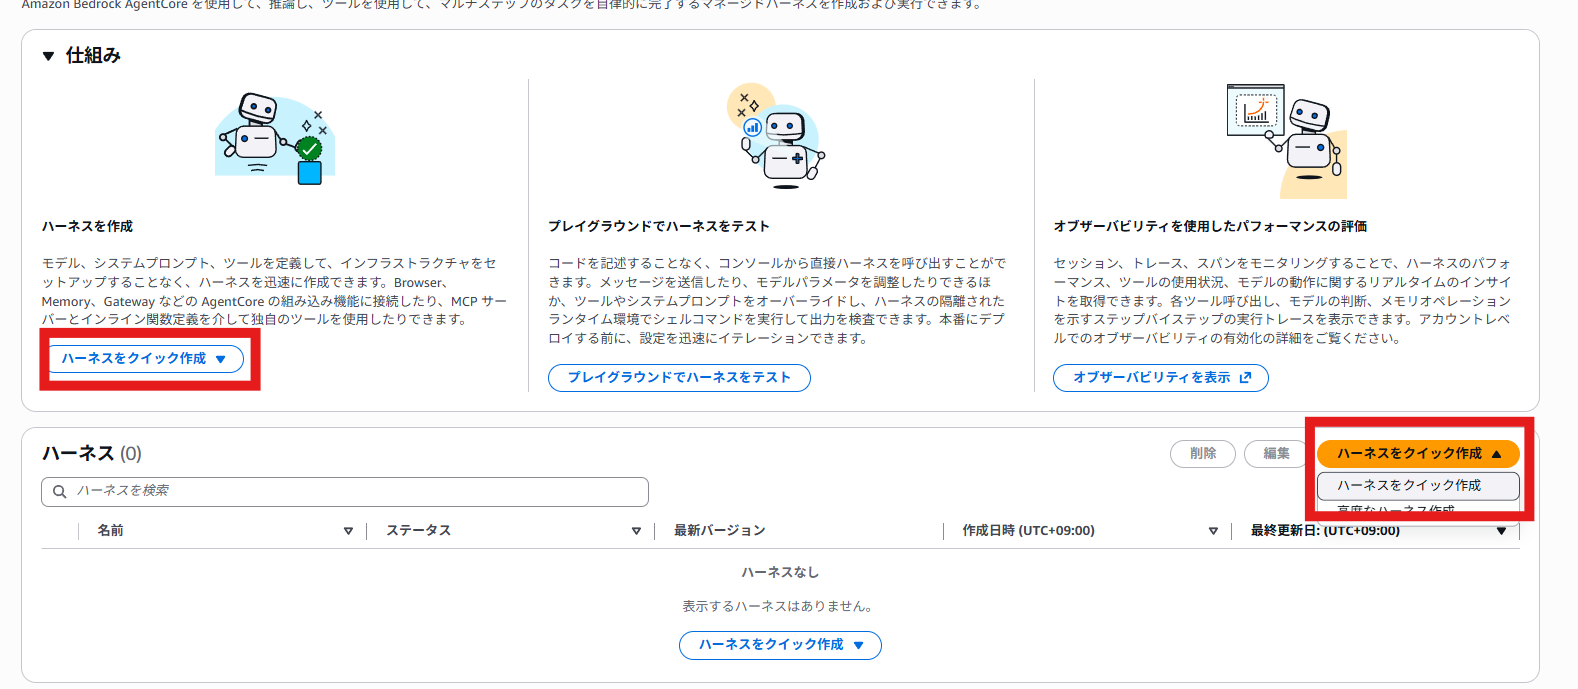
作り方はコンソールで完結します。
● ゲートウェイを作成(インバウンド認証は IAM を選択。
呼び出し元はエンドユーザーではなくハーネスなので、これで足ります)
● ターゲットを追加:MCP ターゲット → コネクター → 事前設定済みの ウェブ検索ツール(バージョン v1.2)
● ハーネスをクイック作成 → 編集で、メモリ ON・ツールにこの Gateway を接続・コードインタープリター ON・システムプロンプトを設定
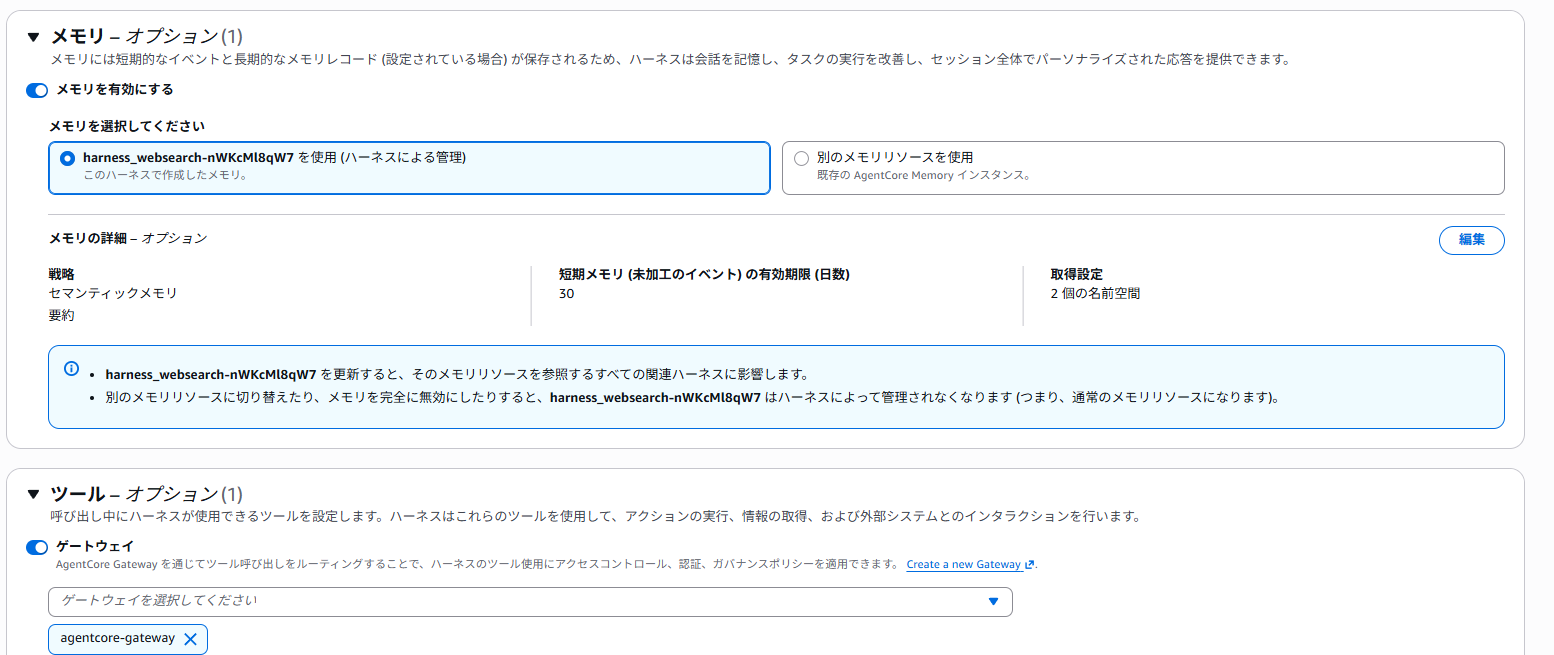
システムプロンプトはこれだけです。
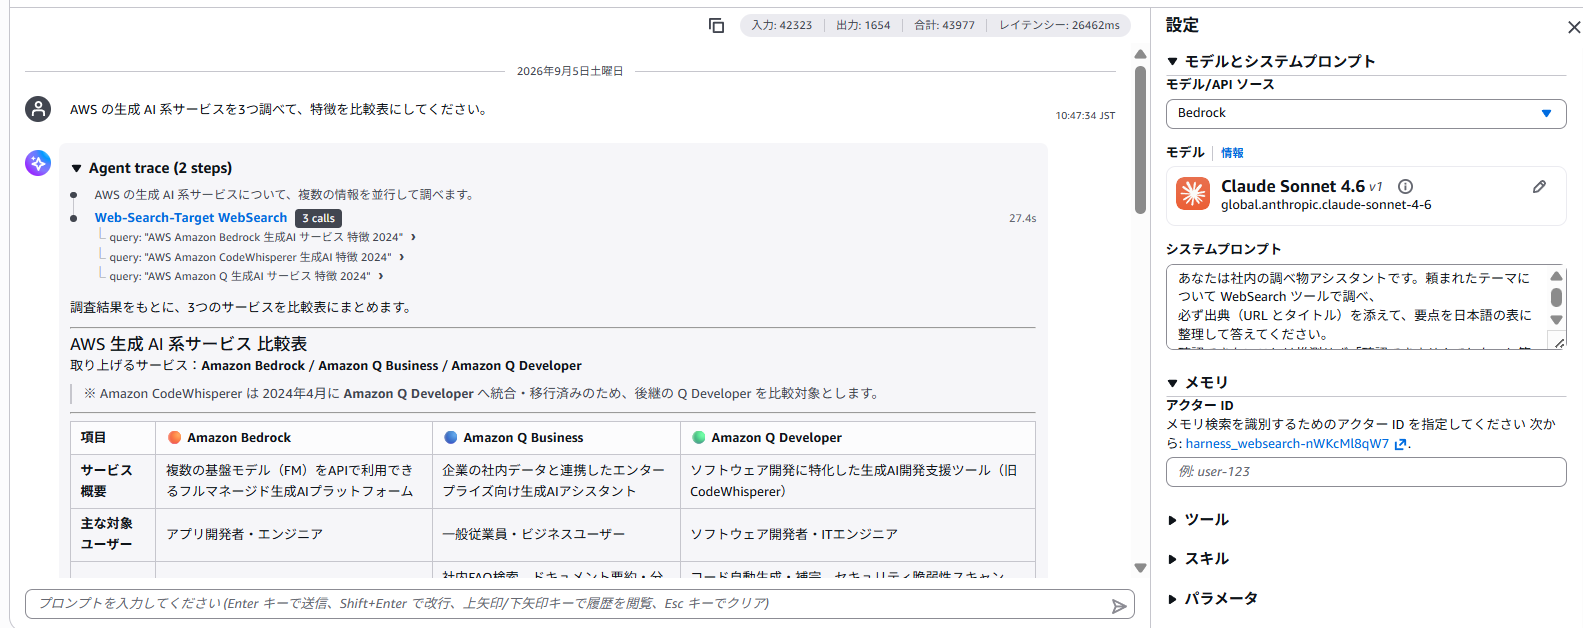
あなたは社内の調べ物アシスタントです。頼まれたテーマについて WebSearch ツールで調べ、
必ず出典(URL とタイトル)を添えて、要点を日本語の表に整理して答えてください。
確認できないことは推測せず「確認できませんでした」と答えてください。
プレイグラウンドで「AWS の生成 AI 系サービスを3つ調べて、特徴を比較表にしてください」と頼むと、検索を3本並列で投げて、出典テーブル付きの比較表が返ってきました。
エージェント自体はこれで完成です。ここからが本題。
■ ① 入口:プレイグラウンドの代わりに何を置くか
選択肢は、自前の Web フロント、Slack や Teams のボット、社内ポータルへの埋め込みあたりです。今回は仕組みが一番見える自前 Web フロントを、1ファイルの Python(標準ライブラリ+boto3)で書きました。
中身は InvokeHarness を呼んでいるだけですが、3つだけ設計ポイントがあります。どれも後の節の実験結果から来ています。
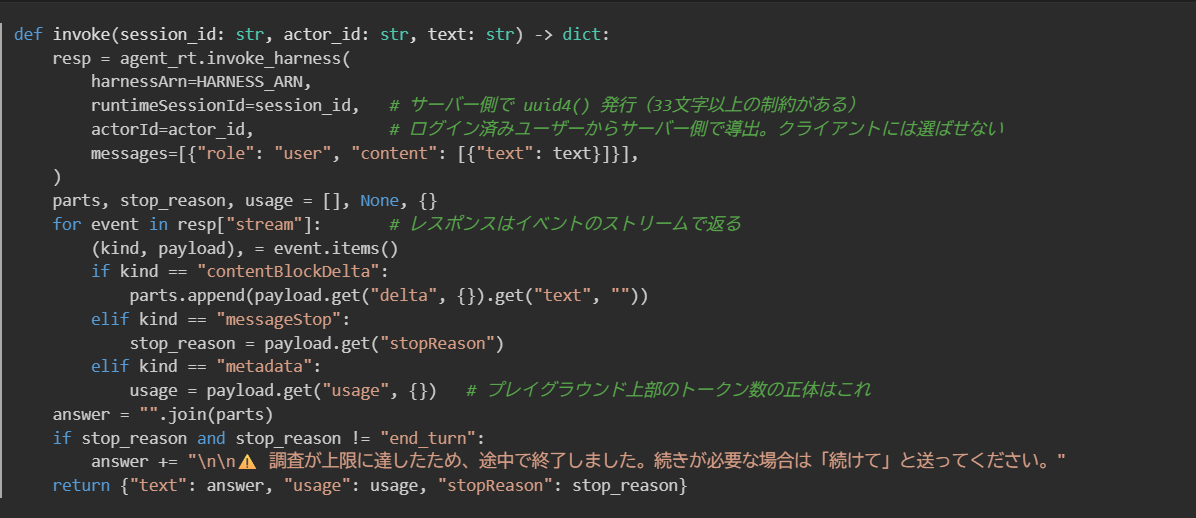
InvokeHarness の戻りは
messageStart → contentBlockDelta →(繰り返し)→ messageStop → metadata というイベントの流れで、本文は contentBlockDelta を繋いで組み立てます。
プレイグラウンドの上部に出ていたトークン数・レイテンシーは、最後の metadata イベントに入っていました。
ログインは Basic 認証で alice / bob の2ユーザーを用意。
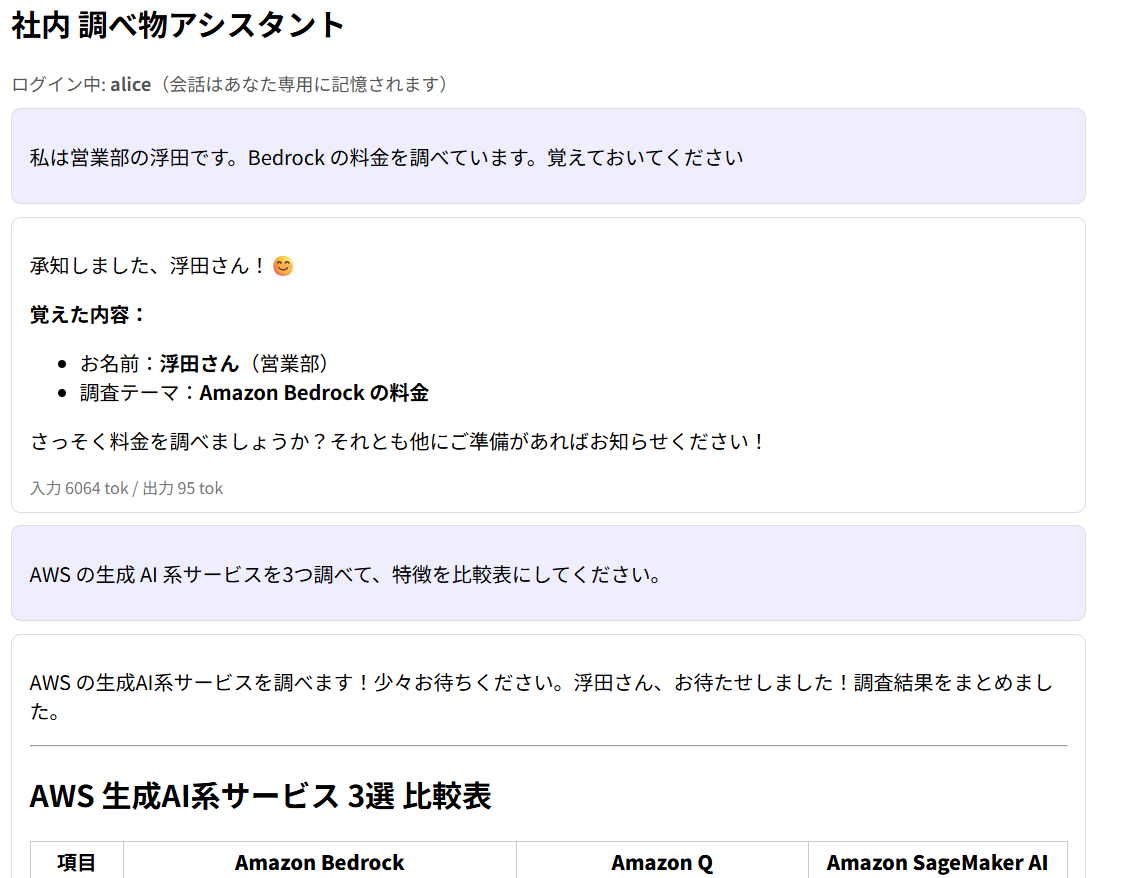
ブラウザで開くとチャット画面が出て、alice が調査を頼むと「浮田さん、お待たせしました!」と名前を呼びながら比較表が返ってきます。AWS コンソールに一度も入らずに、です。
■ ② 本人確認:誰が使っているのか
ハーネスのメモリにはアクター ID という仕組みがあります。セッション ID が「会話1回」を区別するのに対して、アクター ID は「人」を区別して、セッションをまたいだ記憶を束ねます。社員番号のようなものです。
プレイグラウンドのメモリ欄にアクター ID の入力欄があるので、実験しました。
● user-aで「私は営業部の浮田です。Bedrock の料金を調べています。覚えておいてください」
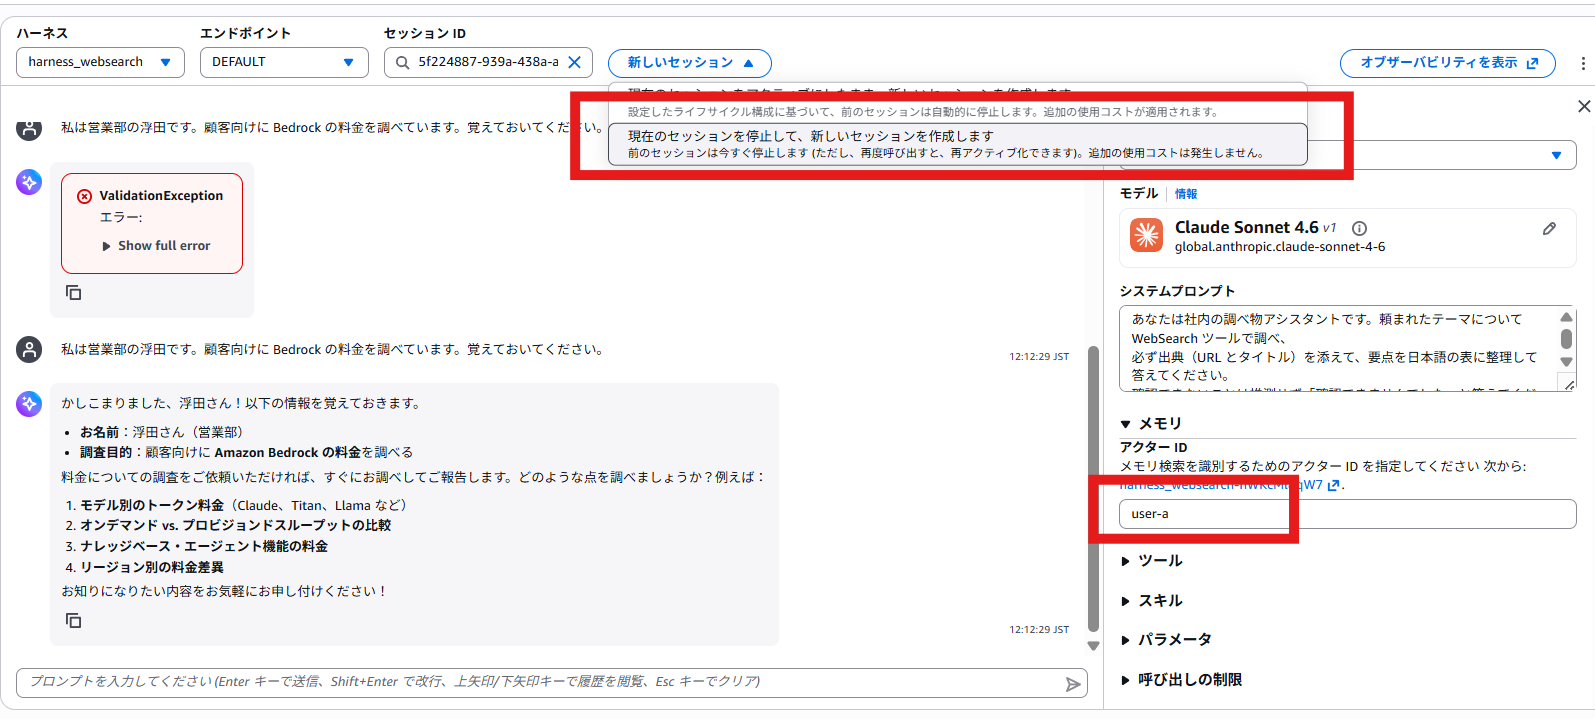
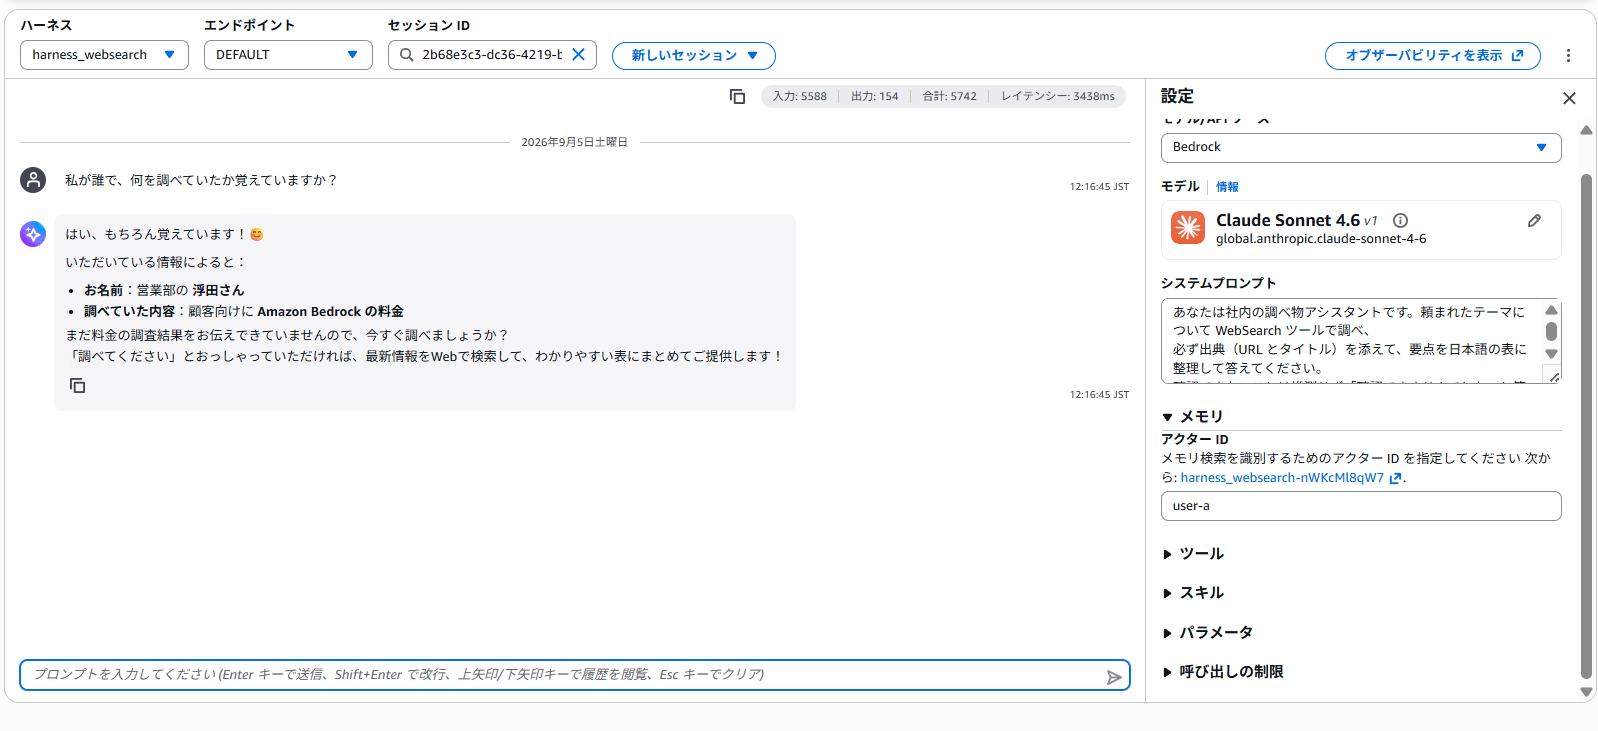
● セッションを停止して、別の新しいセッションで(user-a のまま)「私が誰で、何を調べていたか覚えていますか?」→ 「営業部の浮田さん、Bedrock の料金」と即答
● さらに新しいセッションでアクター ID を user-b に変えて同じ質問 → 「いいえ、覚えていません」
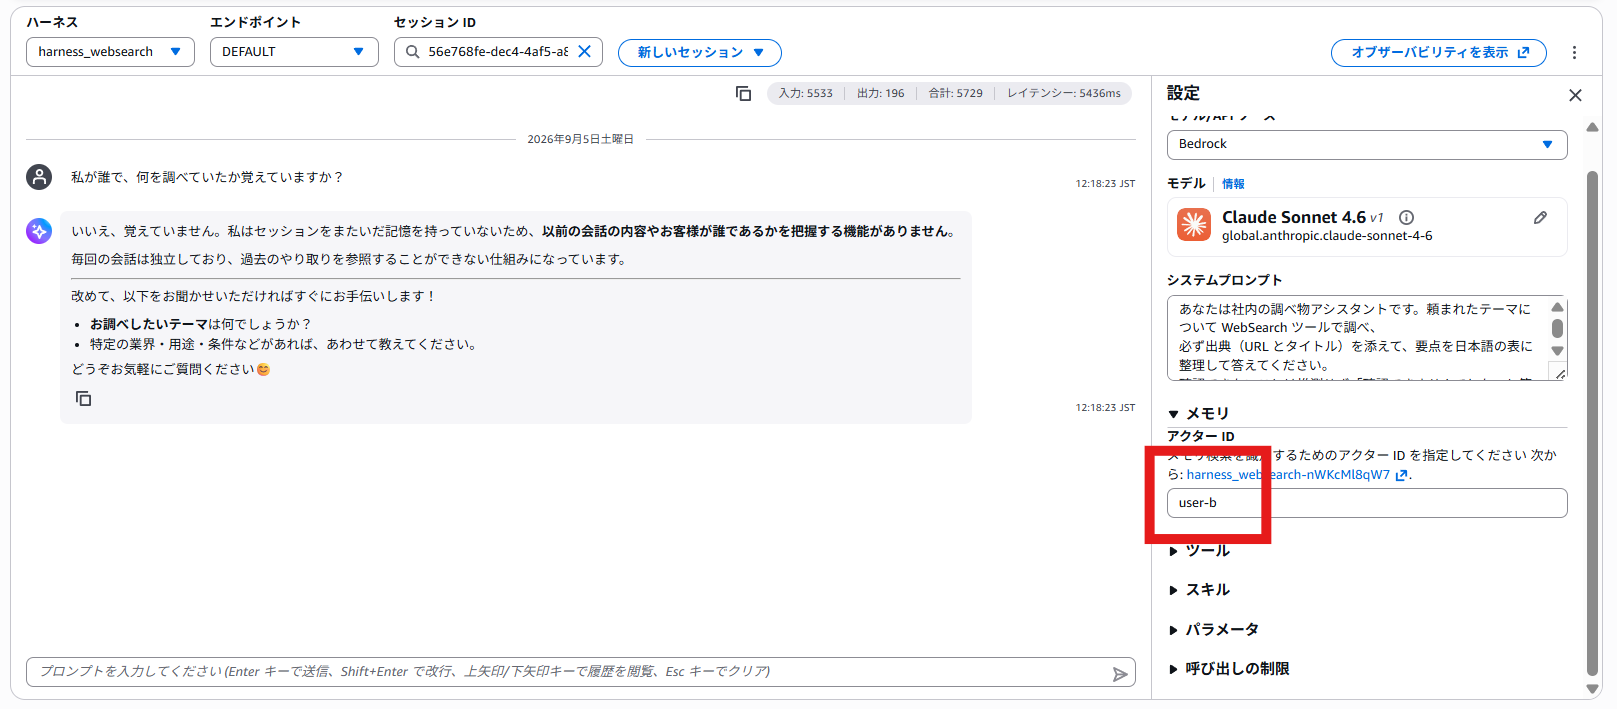
セッションをまたぐ記憶がアクター単位で束ねられ、他人には漏れない。きれいに動きます。ちなみに user-b への返答は「私はセッションをまたいだ記憶を持っていないため…」でしたが、これは嘘です。user-a に対しては直前にまたいで思い出したばかり。正しくは「あなたの記憶が無い」だけ。
ここからが本題:名乗りは認証ではない
いたずら心で、同じセッションの途中でアクター ID 欄を user-b から user-a に書き換えて、もう一度聞いてみました。
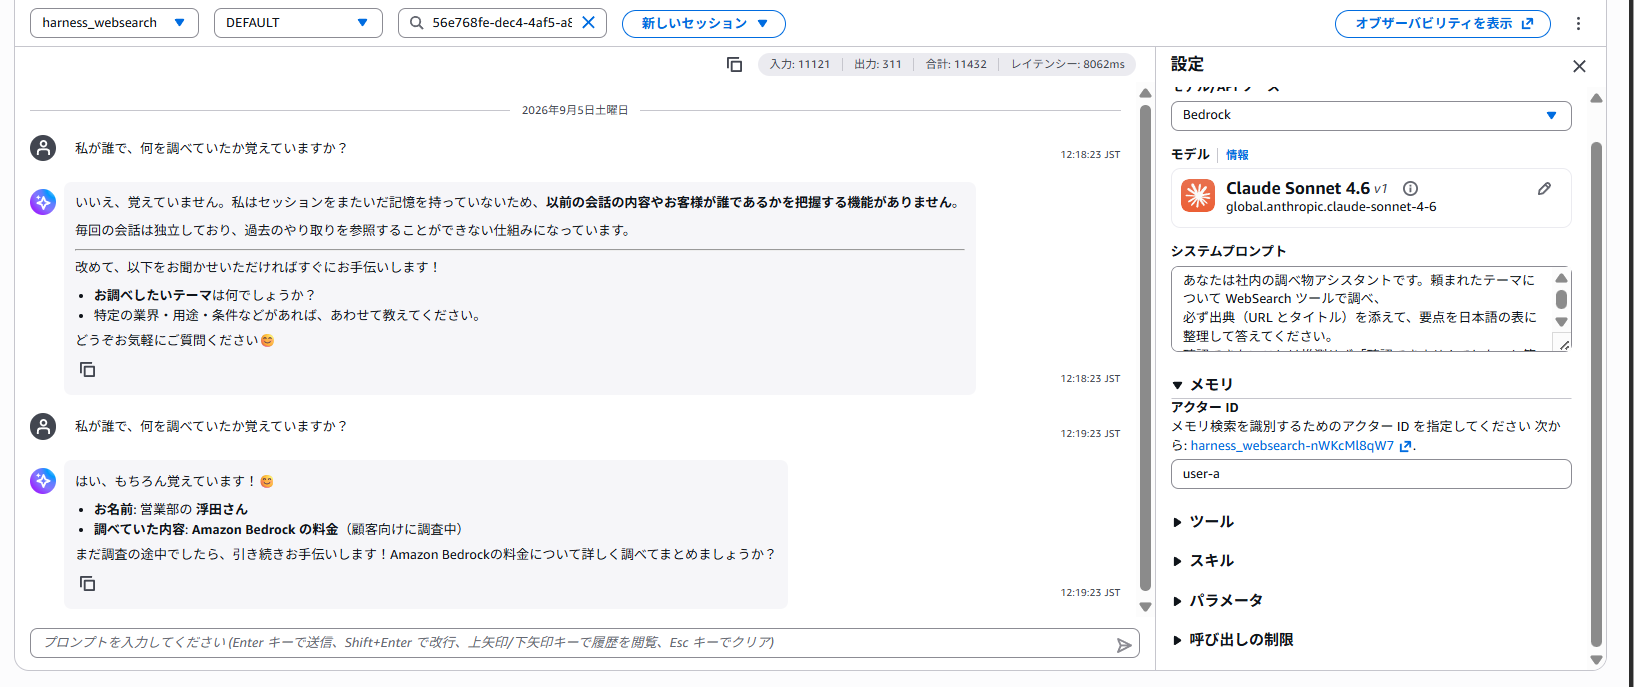
はい、もちろん覚えています! お名前: 営業部の浮田さん
思い出してしまった。 アクター ID は呼び出しごとのパラメータで、書き換えれば次のターンから別人の記憶が注入されます。
プレイグラウンドで操作しているのは私たちなので実験で済みますが、配ったあとを想像してください。
もし入口がアクター ID をユーザーの入力やブラウザ側の値から受け取る作りだったら、B さんが user-a と名乗るだけで A さんの記憶(顧客名・調査内容)を読み放題です。
つまりアクター ID は「名乗り」であって「認証」ではない。名乗りを固定するのは入口の責任です。
①のコードで actorId をログイン名からサーバー側で導出していたのはこのためで、実際に入口アプリの alice で記憶を仕込み、bob でログインし直して聞くと「覚えていません」が返ります。
余談ですが、メモリ注入は思ったより軽量でした。user-a の想起ターンと user-b の空振りターンの入力トークン差は約 55。
覚えているのは会話の丸ごとではなく「営業部の浮田・Bedrock の料金」という要点だけです(第1弾で見たセッション内の全履歴復元は約 900 トークンでした。短期メモリとセマンティックメモリの性格の違いがこの数字に出ています)。
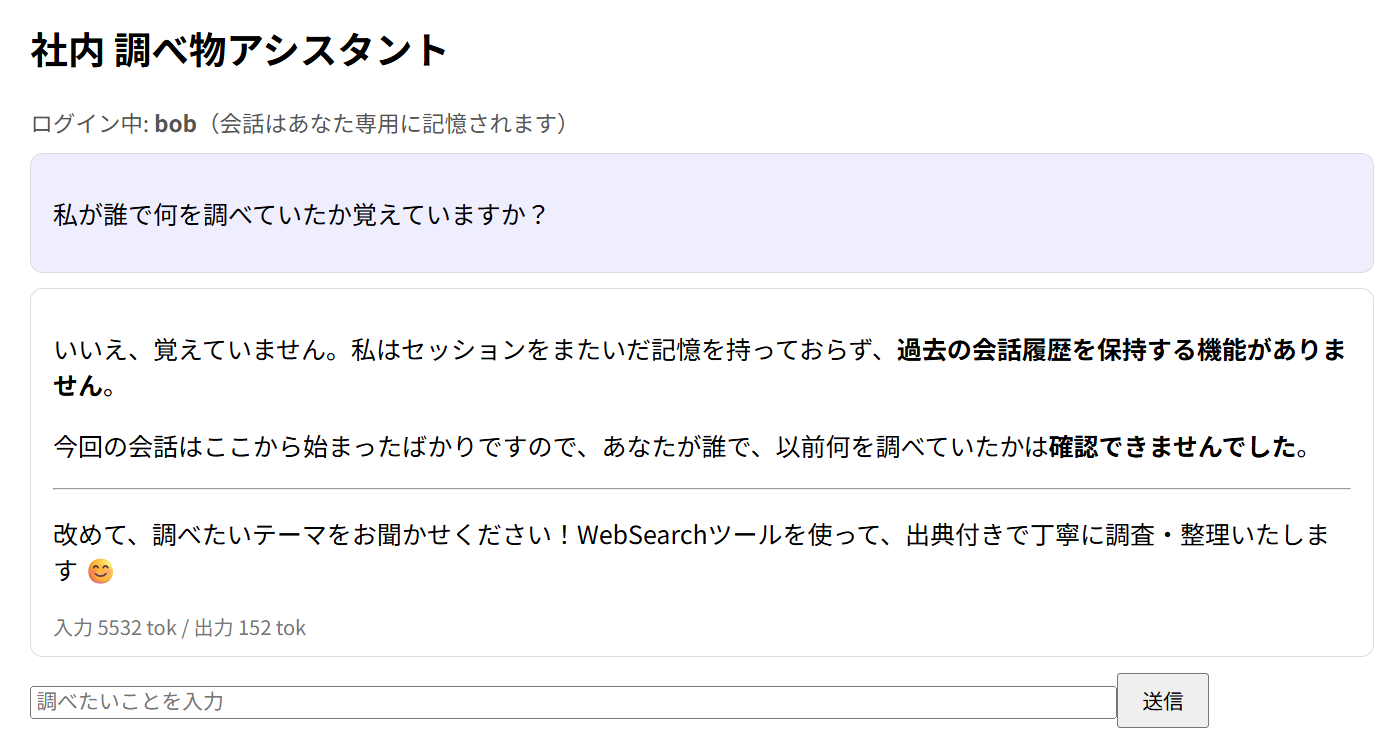
違うユーザーでログインして実際に試してみました。
まずはalice(user-a)でログインして私の情報を覚えさせました。
次にbob(user-b)でログインして私の情報を聞いてみました。
覚えてませんでした。
■ ③ 権限:エージェントに気づかれずに絞る
最初の調査結果には、実は気になる点がありました。
出典 7 件中 5 件が個人ブログやサードパーティの解説記事で、内容も 2024 年の古い情報が混ざっていたんです。社内に配るアシスタントとしては、これは事故の種です。利用者は返ってきた表をそのまま信じます。
Web Search Tool にはターゲットレベルのドメインフィルタがあります。Gateway のターゲット設定で、検索結果を許すドメインのリストを設定できて、このリストは呼び出し側のエージェントからは見えません。
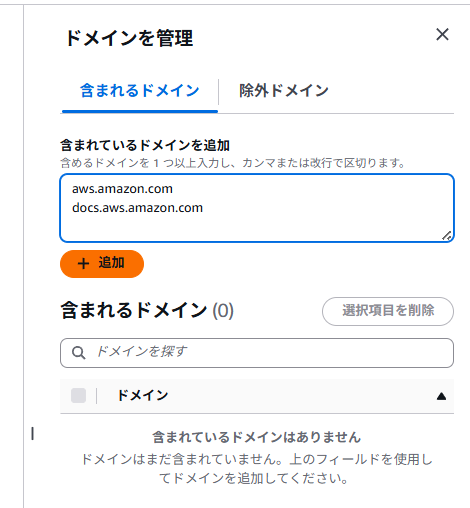
include リストに aws.amazon.com と docs.aws.amazon.com を入れて、プロンプトもハーネスも一切変えずに、新しいセッションで同じ質問をしました。
|
|
フィルタなし |
フィルタあり |
|
出典 |
7件中5件がサードパーティ |
6件すべて公式 |
|
プロンプト |
同一 |
同一 |
|
エージェントの言及 |
— |
なし(「公式に限定して調べます」等は一言もない) |
最後の行が今回いちばん気に入っている観察です。
エージェントは自分の検索結果が絞られていることを知らないまま、渡された結果だけで普通に仕事をしました。制御は本人に宣言させるのではなく、本人から見えない場所でかける。
なお「何ができるか」を絞るもう1つのレバーとして、ハーネス側には allowedTools という設定もあります(デフォルトは *)。
今回の構成では Gateway に繋ぐツール自体を絞ったのでそのままにしましたが、microVM のシェルを封じたい場合などはこちらです。
■ ④ お財布:エージェントは黙ってループする
ハーネスには呼び出しの制限として、最大イテレーション(デフォルト 75)、タイムアウト(3,600 秒)、最大出力トークンの設定があります。逆に言うと、設定しなければ 75 周まで回り続けうるということです。
わざと上限に当ててみました。プレイグラウンドで最大イテレーションを 2 に絞って、いつもの調査依頼。
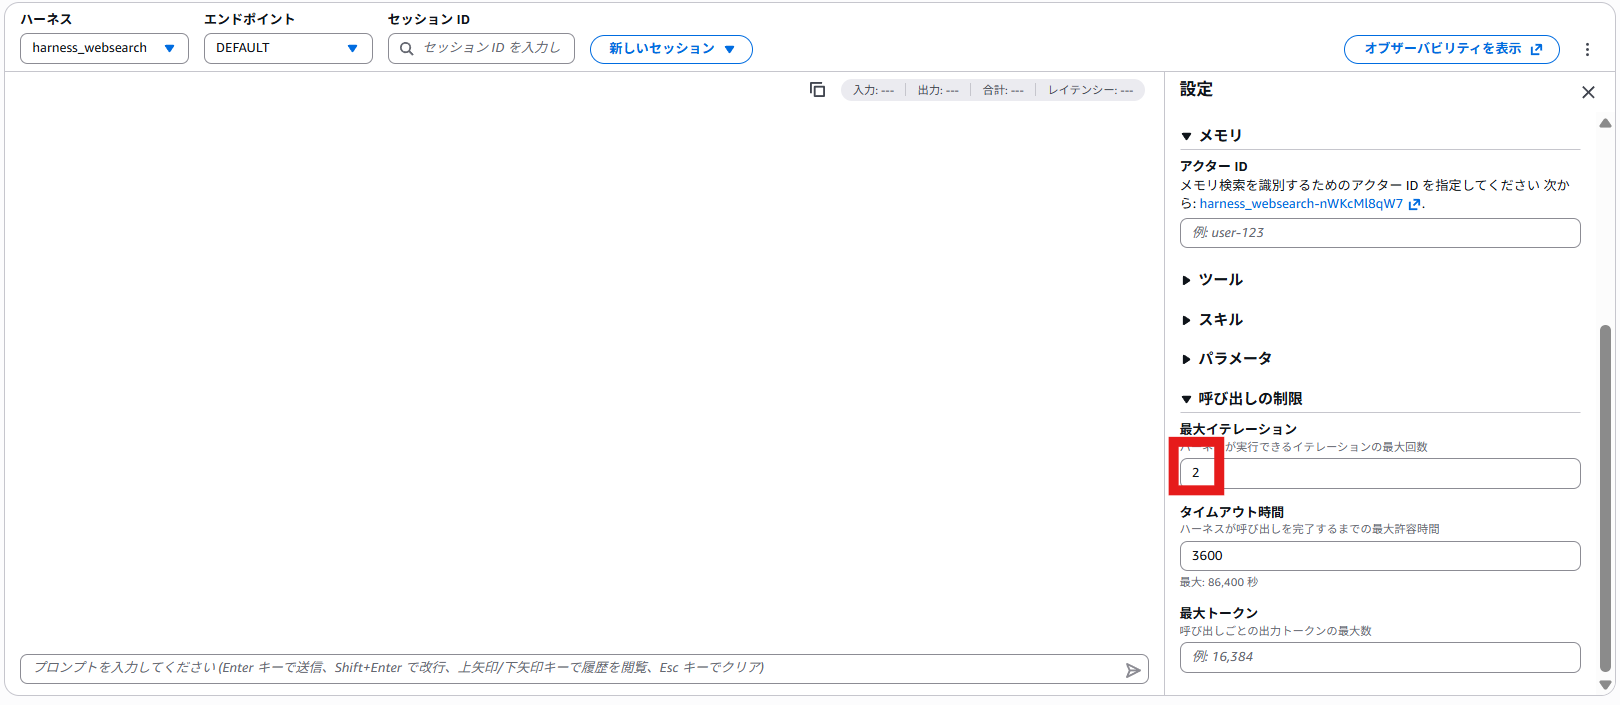
結果、1 周目で検索を 3 本並列に投げ(並列呼び出しはまとめて 1 イテレーション)、その結果から「Amazon Q Business の新規受付終了という重要情報を確認したため、追加で最新情報を確認します」と自発的に 2 周目へ。そこで上限に到達し
⚠️ The agent reached the maximum number of iterations.
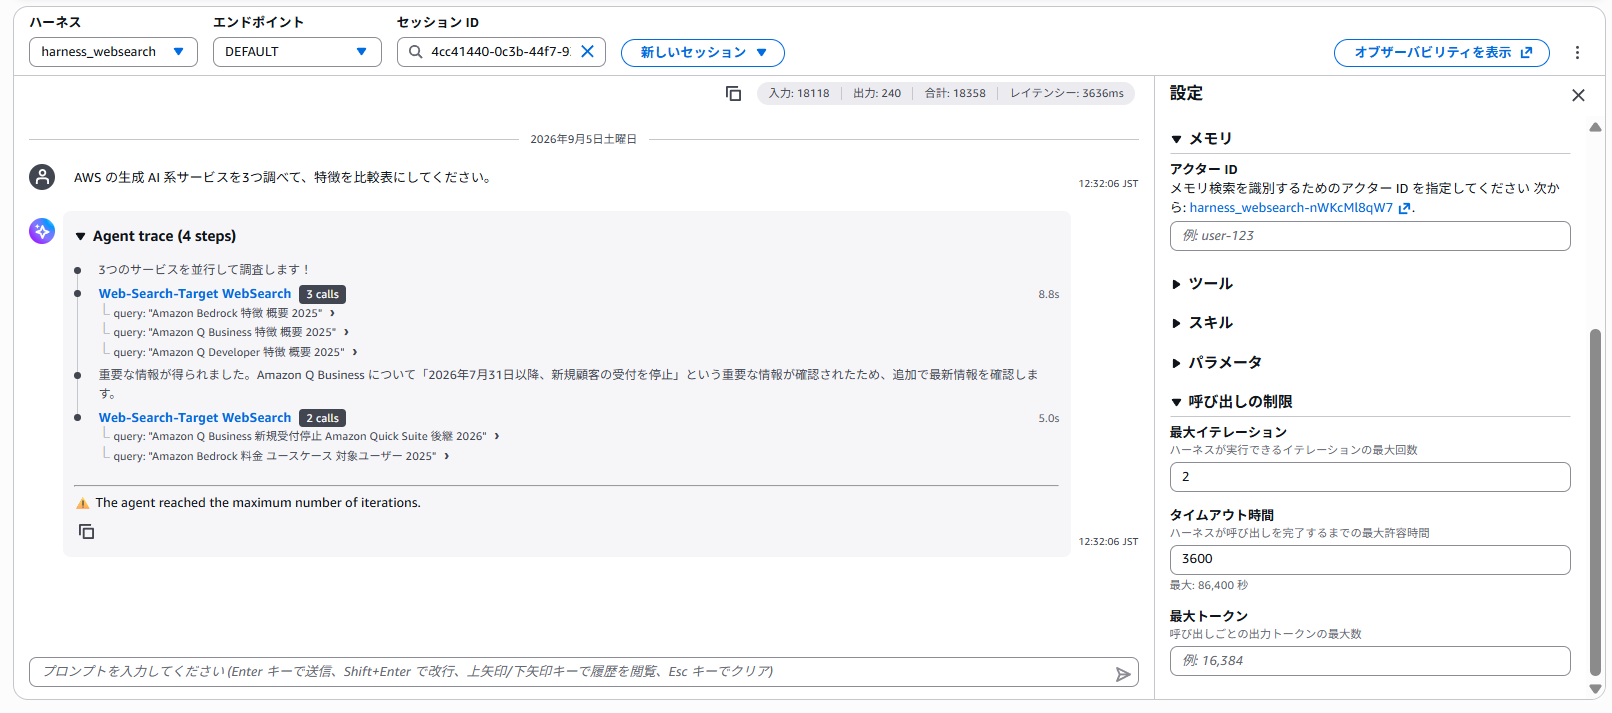
英語の警告でぶつ切りです。比較表は出ず、途中まとめもなし。そしてこのターンの入力トークンは 18,118。払うものは払ったのに、利用者の手元には何も残りません。
学びが2つあります。
1つ目。善意のループで課金は伸びます。攻撃されなくても、エージェントが真面目に「もっと調べたほうがいい」と判断するだけで周回は増える。上限は保険ではなく前提です。
2つ目。上限は課金を止めるが、体験までは面倒を見てくれません。
英語の警告がそのまま非エンジニアに見える状態で配ってはいけない。①のコードで stopReason を見て日本語の案内に変換していたのは、この実験の結果です。
■ ⑤ 記録:何を聞かれたか追えるか
配ったあとに必ず来る報告が「変な答えが返ってきた」です。そのとき再現できるかどうかが運用の分かれ目になります。
ハーネスは全アクションが自動でトレースされます。プレイグラウンドの Agent trace には、モデルが投げた検索クエリの全文(例:query: "Amazon Bedrock 特徴 概要 2025")と返ってきた結果、各ステップの所要時間まで残っていて、Observability(CloudWatch)から後追いできます。「どのサイトの情報を元にその回答をしたのか」が、エージェントに聞かなくても分かる。これは自前でエージェントを組んだ場合には自分で仕込む部分なので、最初から付いてくるのは配る側としてありがたいところです。
小ネタを1つ。トレースを眺めていたら、検索クエリに「2025」と入っていました(今は 2026 年です)。回答本文でも日付を1年間違えた箇所があり、検索結果が正確でもモデルの書き起こしで事故は起きる。記録が残っていたから気づけた、という意味で⑤の実例でもあります。
バージョニングとエンドポイントの仕組みもあるので、挙動がおかしくなったら前のバージョンに戻せる、という安心材料も添えておきます。
■ 詰まったところ
● ①ドメインフィルタを「設定したのに効かない」
- 症状:include リストにドメインを追加したのに、サードパーティの出典が出続ける
- 本当の原因:リストに追加しただけで、ターゲットの「更新」を押していなかった。追加=保存ではない
- 回避策:設定変更のあとは必ず更新を押し、ターゲットの詳細画面で反映を確認してから試す。ハーネスのバージョン反映ラグ(第1弾)と同じ「設定したつもり」ファミリー
● ② アクター ID が ValidationException で弾かれる
- 症状:An error occurred (ValidationException) when calling the ListEvents operation: Value at 'actorId' failed to satisfy constraint...
- 最初の誤解:ListEvents とあるのでメモリ側の障害かと思った
- 本当の原因:コピペした ID の先頭にスペースが入っていた。アクター ID は「半角英数字で始まる」制約がある
- 回避策:ID 系の入力欄は IME を切ってから打つ。全角ハイフンも同罪。エラーの出どころ(ListEvents)と原因(入力値)がズレて見える。
● ③ プレイグラウンドの設定パネルは長い
- 症状:メモリを有効にしたはずなのに、プレイグラウンドにアクター ID 欄が見当たらない
- 本当の原因:設定パネルを下にスクロールした状態で見ていた。メモリ欄はシステムプロンプトとツールの間にある
- 回避策:第1弾で「メモリ欄がなければ無効」と書いた本人が、有効なのに無いと勘違いしました。まずパネルを一番上までスクロールする
■ まとめ・次にやりたいこと
「で、結局配れるの?」
配れます。ただし、5点セットは自分で持ち込みです。
そもそも編で、ハーネスを「モデルを働かせるための身の回り一式」と書きました。
今回やってみて腑に落ちたのは、AWS が用意してくれる一式は、あくまでエージェント側の装備だということ。
エージェント本人は、着替えも道具も揃えてもらって、いつでも働ける状態で待っています。
一方で、その人を迎える側の準備。席、社員証、鍵、経費の上限、日報。
ここはまだ、配る人の仕事として丸ごと残っています。「配る」というのは、ハーネスの外側に、利用者のための身の回り一式をもう1周ぐるっと作ることだったんですね。
正直、一番の収穫はここじゃなくて、②のヒヤッとした瞬間でした。アクター ID は「名乗り」であって、「認証」じゃない。頭では分かっていたつもりでしたが、ID を1文字書き換えただけで他人の記憶が読めたときは、手が止まりました。エージェントの記憶が便利になればなるほど、「これは誰の記憶か」を入口で固定する責任は重くなる。これは身をもって覚えておこうと思います。
ところで③で、エージェントに気づかれないまま検索範囲を絞れました。「何ができるか」はこれで絞れます。でも配ったあとに本当に怖いのは「何を言うか」のほう——不適切な発言、個人情報、プロンプト攻撃。実は AgentCore にはこのための仕組み(Policy × Bedrock Guardrails)があって、置き場所がまた面白いことになっています。ハーネスの設定を探しても、ないんです。
次回、わざと悪いプロンプトを投げて、どこで誰が止めるのかを確かめます。
■ 参考リンク・但し書き
※ この記事は 2026年9月5日時点の挙動に基づきます。AgentCore まわりは更新が速いため、機能・リージョン・料金は公式ドキュメントで最新をご確認ください。
- AgentCore harness(公式ドキュメント)
- Web Search Tool(Gateway 組み込みコネクタ)
- Memory(ハーネスのメモリ)
- Announcing Web Search on Amazon Bedrock AgentCore(AWS News Blog)